Metoda SIRT: obecně a v TomoTree
Tento dokument vysvětluje metodu SIRT (Simultaneous Iterative Reconstruction Technique)
od základní myšlenky po konkrétní implementaci Tomo.do_SIRT_method
(src/tomotree/classes/_tomo_reconstruction.py), v aplikaci stránka
Tomograph → SIRT method. Navazuje na:
methods.md – stručná matematika (anglicky),
sirt_report.md – co se na metodě opravilo v říjnu 2026 a proč,
backprojection.md – zpětná projekce (FBP), která řeší stejnou soustavu jinak.
Obrázky a tabulky vytváří python docs/sirt_figures/make_figures.py (asi 10 s). Všechny
pokusy používají syntetický strom: kruh o poloměru 30 cm, 12 senzorů, zdravé dřevo
1500 m/s, mimostředová dutina o poloměru 10 cm s rychlostí 500 m/s (čárkovaný kruh
v obrázcích), mřížka 40 × 40 buněk, přesné doby průletu po přímkách.
Část I – princip
1. Úloha
Senzory na obvodu kmene měří doby průletu napěťové vlny \(b_i\) mezi dvojicemi senzorů. Řez rozdělíme na buňky a v každé buňce hledáme pomalost \(x_j = 1/v_j\) (s/m). Pro přímý paprsek \(i\) je doba průletu součtem „délka v buňce × pomalost buňky“:
kde \(a_{ij}\) je délka \(i\)-tého paprsku v \(j\)-té buňce. Pomalost se používá místo rychlosti proto, že doba průletu je v pomalosti lineární; v rychlosti by nebyla.
Matice \(A\) je řídká (paprsek protne jen malou část buněk) a hlavně široká: 12 senzorů dá \(\binom{12}{2} = 66\) paprsků, ale mřížka 40 × 40 má uvnitř kmene téměř tisíc buněk. Soustava je silně podurčená: řešení je nekonečně mnoho a měřená data samy o sobě nevyberou to správné. Navíc je měření zatížené šumem, takže přesné splnění \(Ax = b\) ani není žádoucí.
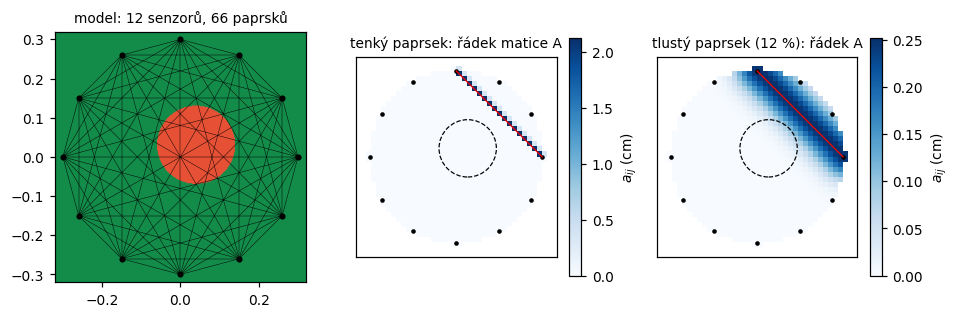
Vlevo model se všemi 66 paprsky. Uprostřed jeden řádek matice \(A\) pro tenký paprsek (nenulové jen buňky, které přímka protíná, hodnota = délka úseku v buňce). Vpravo tentýž řádek pro tlustý paprsek (oddíl 6): délka paprsku je rozdělena do pásu buněk kolem přímky.
2. Od Kaczmarze k SIRT
ART (Kaczmarzova metoda) bere rovnice jednu po druhé. Pro paprsek \(i\) spočítá, o kolik se modelová doba \(\sum_j a_{ij}x_j\) liší od naměřené, a rozdělí tento rozdíl zpět do buněk paprsku úměrně jejich délkám, aby rovnice \(i\) platila přesně:
Výsledek závisí na pořadí paprsků a poslední paprsky „přetahují“ ty první.
SIRT dělá totéž pro všechny paprsky současně (odtud simultaneous): spočítá rezidua všech paprsků, každé rozmaže zpět podél paprsku a pro každou buňku vezme vážený průměr oprav od všech paprsků, které jí procházejí. V jedné iteraci:
projekce – modelové doby \(Ax\) a rezidua \(r = b - Ax\),
normování po paprscích – \(r_i / \rho_i\), kde \(\rho_i = \sum_j a_{ij} = L_i\) je délka paprsku; \(r_i/L_i\) je chyba pomalosti „na metr paprsku“,
zpětná projekce – buňka \(j\) dostane \(\sum_i a_{ij}\, r_i/L_i\),
normování po buňkách – dělení \(\gamma_j = \sum_i a_{ij}\) (celková délka paprsků v buňce): oprava je průměr chyb pomalosti všech paprsků přes buňku, vážený délkou průchodu.
Maticově
První iterace z homogenního modelu je tedy prostá zpětná projekce rezidua (viz backprojection.md); další iterace postupně opravují rozmazání, které prostá zpětná projekce způsobí.
3. Obecný tvar a konvergence
Van der Sluis a van der Vorst (1990) studují celou třídu metod
s \(0 \le \alpha \le 2\). Volba \(\alpha = 1\) (řádkové a sloupcové součty) je výše popsaný klasický SIRT a používá ji i TomoTree. Pro \(0 < \omega < 2\) iterace konverguje (věta 4.10 v článku) k řešení vážené úlohy nejmenších čtverců
v metrice dané \(C^{-1}\); z homogenního (nebo nulového) startu míří k řešení nejbližšímu počátečnímu modelu.
Relaxace \(\omega\) je délka kroku. \(\omega < 1\) konverguje pomaleji a klidněji, \(\omega\) blízko 2 rychleji, ale může oscilovat.
Semikonvergence. S šumem v datech se chyba vůči skutečnosti nejprve zmenšuje (iterace zachycují hrubé rysy) a pak zase roste (iterace začnou „vysvětlovat“ šum). Počet iterací tak sám působí jako regularizace. U klasického SIRT na stromě je tento jev výrazný (oddíl 4, obr. 3).
4. Proč klasický SIRT na stromech selhává
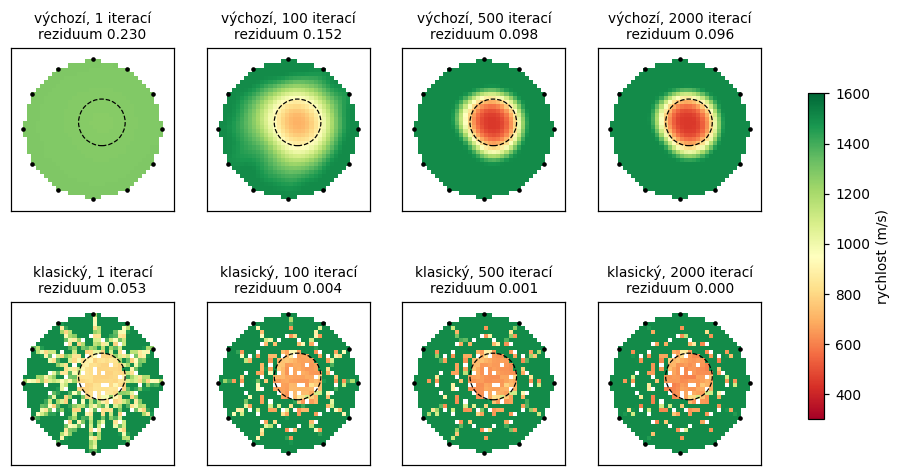
Tomogram po 1, 100, 500 a 2000 iteracích. Horní řada: nastavení TomoTree (vyhlazení 10, tlusté paprsky 12 %). Dolní řada: klasický SIRT (bez vyhlazení, tenké paprsky).
Klasický SIRT (dolní řada) splní naměřené časy téměř přesně (reziduum 0,0004 po 2000 iteracích), a přesto dává špatný obraz:
hvězdice – každý paprsek nese svou opravu jen buňkami, kterými přímo prochází, takže obraz je složený z čar mezi senzory;
šachovnice – buňka, kterou protíná jediný paprsek, může mít téměř libovolnou hodnotu; iterace do ní „uloží“ zbytek rezidua;
prázdné buňky – buňky mezi paprsky nemají rovnici vůbec a zůstanou bez hodnoty;
šum – s 3 % šumem v časech dá klasický SIRT nejmenší chybu po první iteraci, pak se obraz už jen zhoršuje (zelená čárkovaná křivka na obr. 3).
Řešením je doplnit apriorní informaci: rychlost se mezi sousedními buňkami mění plynule (regularizace) a vlna „cítí“ pás kolem přímky, ne jen přímku (tlusté paprsky). To jsou dvě hlavní úpravy v TomoTree.
Část II – implementace v TomoTree
Vstupní bod je Tomo.do_SIRT_method v src/tomotree/classes/_tomo_reconstruction.py.
Průběh:
Tomo(..., reaction_time=t0)        odečtení reakčního času od časů paprsků (oddíl 8)
do_SIRT_method
 ├─ fix_velocity_EBSI(...)          volitelná korekce anizotropie (oddíl 11)
 ├─ _ray_cell_system(...)           matice A, vektor b, seznam neznámých buněk (oddíl 5)
 │   └─ _fat_ray_matrix(...)        tlusté paprsky (oddíl 6)
 ├─ _speed_bounds(...)              meze rychlosti (oddíl 9)
 ├─ Laplaceův operátor D            regularizace (oddíl 7)
 ├─ iterace SIRT + ořez na meze     (oddíl 9)
 └─ _set_cell_slowness(...)         zápis rychlostí do buněk a segmentů (oddíl 10)
5. Sestavení soustavy: _ray_cell_system
Dělení paprsků na segmenty. Pro paprsek z \(P_s\) do \(P_e\) se spočítají parametry \(t \in [0, 1]\) průsečíků přímky \(P_s + t(P_e - P_s)\) se všemi svislými (\(x\) = konst.) a vodorovnými (\(y\) = konst.) čarami mřížky. Seřazené parametry dělí paprsek na segmenty, z nichž každý leží v jedné buňce. Segmenty nulové délky (čára mřížky prochází senzorem) se zahodí; paprsky rovnoběžné s osou nedělí nulou.
Přiřazení buňce. Segment patří buňce, ve které leží jeho střed (
grid.get_cell).Matice délek. \(a_{ij}\) = součet délek segmentů paprsku \(i\) v buňce \(j\) (
scipy.sparse.coo_matrix), \(b_i = L_i / v_i\) z naměřené rychlosti paprsku.Neznámé. Buňky, kterými prochází aspoň jeden paprsek, a při
smoothing > 0navíc všechny buňky uvnitř obvodu kmene (compute_inside_mask). Bez vyhlazení by buňky bez paprsku neměly žádnou rovnici, s vyhlazením je určí sousedé. Indexy neznámých buněk jsou vsystem['idx'], matice \(A\) má jen tyto sloupce.
6. Tlusté paprsky: _fat_ray_width, _ray_cell_weights, _fat_ray_matrix
Napěťová vlna o vlnové délce \(\lambda\) (ve dřevě při 2–5 kHz zhruba 0,25–0,6 m) není citlivá jen na přímku mezi senzory, ale na Fresnelovu zónu kolem ní o šířce řádu \(\sqrt{\lambda L}\). Tlustý paprsek tuto zónu napodobí:
kde \(d_{ij}\) je vzdálenost středu buňky \(j\) od úsečky paprsku a \(w\) šířka paprsku. Buňky dál než \(2{,}5\,w\) se ignorují (váha je tam pod \(e^{-6{,}25} \approx 0{,}002\)).
Součet řádku = délka paprsku, takže homogenní strom se zrekonstruuje přesně a normování \(R\) v iteraci (oddíl 2) zůstává smysluplné.
ray_width='auto'(výchozí) znamená \(w\) =ray_width_ratio× průměr kmene, kde průměr je největší vzdálenost dvou senzorů; výchozí poměr 0,12.ray_width=Nonenebo 0 = tenké paprsky.Paprsek, v jehož okolí \(2{,}5\,w\) není žádná neznámá buňka, si nechá řádek z tenké matice.
Cena: nižší rozlišení. Defekty menší než zhruba šířka paprsku se rozmažou.
Na obrázku 1 vpravo je vidět, že tlustý paprsek rozprostře svou délku do pásu buněk; hodnoty \(a_{ij}\) jsou proto menší a nenulových je víc.
7. Regularizace vyhlazením (Tikhonov)
K soustavě se připíše diskrétní Laplaceův operátor \(D\) na neznámých buňkách (4 sousedé):
kde \(k \sim j\) jsou sousední neznámé buňky a \(\deg_j\) jejich počet (u okraje oblasti méně než 4). \((Dx)_j = 0\) znamená, že pomalost buňky je průměrem sousedů. Řešená soustava je
kde \(\alpha\) je parametr smoothing a \(\bar a\) průměrná délka segmentu tenkých paprsků
(lengths.mean()). Díky \(\bar a\) má \(\alpha\) stejný význam pro libovolnou mřížku
a jednotky souřadnic. SIRT tuto rozšířenou soustavu řeší ve smyslu nejmenších čtverců, tedy
hledá kompromis mezi „splň naměřené časy“ a „buď hladký“:
vyhlazení vyplní buňky bez paprsků hodnotami interpolovanými od sousedů,
potlačí šachovnici a hvězdice,
větší \(\alpha\) = hladší obraz, větší reziduum, slabší kontrast defektu,
smoothing=0= klasický SIRT (neznámé jen buňky s paprskem, žádné \(D\)).
Matice se skládá blokově (scipy.sparse.vstack), řádkové a sloupcové součty v iteraci se
počítají z absolutních hodnot celé rozšířené matice \(M\) (Laplacián má záporné prvky).
8. Reakční čas přístroje
Přístroj nemusí znát přesný okamžik úderu, ke všem časům se pak přičte stejné zpoždění \(t_0\) (reakční čas přístroje):
Společné nastavení všech metod. Reakční čas je vlastnost přístroje, ne rekonstrukční
metody. Zadává se proto jednou (Tomo(reaction_time=...),
analysis.reconstruct(reaction_time=...) v sekundách, v GUI pole „Reaction time of the
device/µs“ vedle tloušťky kůry, v config.yaml klíč reaction_time v µs). Odečte se od
naměřených časů hned při vytvoření paprsků, \(t_i \leftarrow t_i - t_0\), tedy ještě před
korekcí anizotropie. Všechny metody (Rays, EBSI, ERSM, SIRT, FBP) pak pracují s čistým časem;
ray.ori_time a ray.ori_speed drží naměřené hodnoty. Výchozí hodnota je 0.
Proč ne další neznámá v soustavě SIRT. Maurer (2006) navrhuje přidat do matice sloupec jedniček a odhadnout \(t_0\) spolu s pomalostmi. Tak to TomoTree dělalo do listopadu 2026 a nefungovalo to: na syntetickém stromu se zpožděním 40 µs vyšel odhad −0,9 µs po 500 iteracích a 28 µs po 2000. Nepomohlo ani přeškálování sloupce, ani přepočet \(t_0\) v každé iteraci. Příčina je v regularizaci: delší paprsky procházejí středem kmene, takže „všechny časy jsou o \(t_0\) delší“ a „střed je o něco pomalejší“ vysvětlí data skoro stejně dobře a vyhlazená inverze dává přednost druhému.
Odhad z dat (jen nápověda). Ve zdravém dřevě platí pro paprsek délky \(L\) přímka
\(t = L/v + t_0\); paprsky přes defekty jsou pomalejší a leží nad ní.
analysis.estimate_reaction_time(data)
proloží přímku \(t = sL + t_0\) všemi paprsky (
np.polyfit),ponechá paprsky s reziduem nejvýše rovným mediánu (rychlejší polovinu),
kroky 1–2 opakuje pětkrát a vrátí úsek \(t_0\) poslední přímky (neořezaný).
Odhad je jen v knihovně, GUI má jen ruční zadání. Záporný odhad znamená, že z dat reakční čas určit nejde.
Na syntetických stromech (dutina, zdravý strom, hniloba u kůry) dá metoda 40–41 µs, s 3 % šumem 41–49 µs. Při hnilobě uprostřed nebo v prstenci kolem středu nefunguje: krátké paprsky u kůry vedou zdravým dřevem, dlouhé hnilobou, závislost času na délce je vypouklá a přímka vyjde se záporným úsekem. Reálná data:
datová sada |
odhad \(t_0\) (µs) |
|---|---|
Jičín_05 |
6 |
black_cherry |
6 |
CS1_Jičín_Tree_1 až 5 |
9, 17, 66, 88, 69 |
Jičín_08, 14, 15 |
−33, −92, −107 (nelze určit) |
9. Iterace
absM = abs(M)
R = 1 / absM.sum(axis=1)          # řádky: délky paprsků (u řádků D součty |D|)
C = 1 / absM.sum(axis=0)          # sloupce: délka paprsků v buňce + vazby na sousedy
x = Σb / ΣL                       # homogenní model: průměrná pomalost
for it in range(iterations):
    x += relaxation * C * (M.T @ (R * (rhs - M @ x)))
    x = clip(x, 1/speed_max, 1/speed_min)
Start z homogenního modelu \(x_j = \sum_i b_i / \sum_i L_i\) (doba všech paprsků dělená jejich celkovou délkou), ne z nuly. Iterace pak opravují jen odchylky od „průměrného stromu“.
Ořez na meze v každé iteraci (projekce na množinu přípustných pomalostí). Výchozí meze (
_speed_bounds): dolní \(\max(340, 0{,}5\, v_{\min})\) m/s, kde 340 m/s je rychlost zvuku ve vzduchu (vlna dutinou neprojde, obejde ji dřevem), horní \(v_{\max}\) (nejrychlejší paprsek, z časů po odečtení reakčního času). Horní mez je fyzikálně rozumná: přímý paprsek nemůže být rychlejší než nejrychlejší dřevo, kterým prochází.Zastavení po
iterationskrocích (výchozí 2000, relaxace 1,5; oddíl Konvergence), nebo dřív, pokud je zadánotola relativní reziduum se mezi dvěma iteracemi změní méně nežtol(GUItolnenastavuje).Report (
t.sirt_reportpři volání přesanalysis.reconstruct):SIRT finished in 225 ms, 2000 iterations, smoothing 10.0, ray width 0.072, 952 cells. Relative residual: 0.0964. Speed interval: min=450 (6 cells at bound 450), max=1500 (673 cells at bound 1500).
Relativní reziduum je \(\|Ax - b\| / \|b\|\) (časy po odečtení reakčního času) jen pro paprsky (bez řádků \(D\)). Počet buněk na mezích ukazuje, jak moc ořez zasahuje. (Report syntetického stromu: šířka paprsku 0,072 m = 12 % ze 60 cm, dolní mez 450 m/s = polovina nejpomalejšího paprsku.)
Konvergence
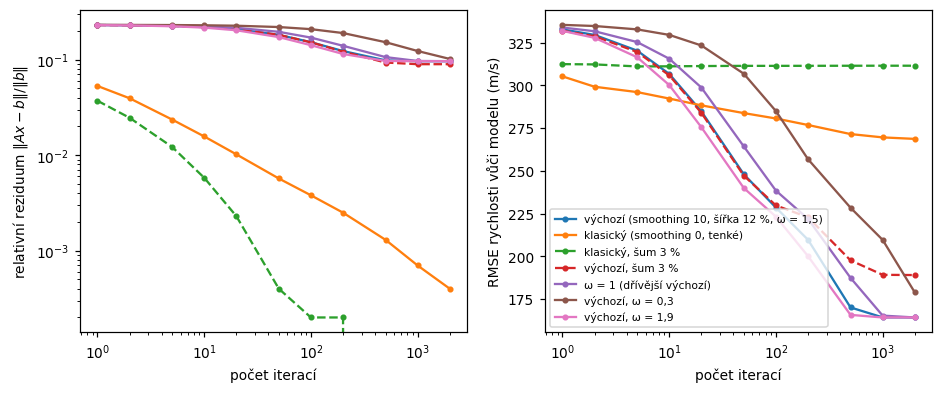
Vlevo relativní reziduum, vpravo chyba rychlosti vůči modelu (RMSE přes buňky uvnitř kmene, buňky bez hodnoty se nepočítají) v závislosti na počtu iterací.
Klasický SIRT (oranžová) snižuje reziduum stále, ale chyba vůči skutečnosti klesá jen nepatrně; se šumem (zelená) je nejlepší hned první iterace – semikonvergence.
S vyhlazením iterace startuje pomalu: reziduum se prvních ~20 iterací skoro nemění, protože vazby na sousedy zvětšují sloupcové součty, a tedy zmenšují krok.
S \(\omega = 1\) (dřívější výchozí nastavení, 500 iterací) výpočet nedokonvergoval: RMSE 187 m/s, limitně 164 m/s. Na datech Jičín_05 se tomogram po 500 iteracích lišil od limitního až o 131 m/s.
Proto je od listopadu 2026 výchozí 2000 iterací s \(\omega = 1{,}5\): na Jičín_05 nejvýše 5 m/s od limitu, 0,16 s pro mřížku 41 × 41 (0,9 s pro 121 × 121). \(\omega = 1{,}9\) konverguje ještě o něco rychleji, \(\omega = 0{,}3\) výrazně pomaleji. Šum (červená čárkovaná) výsledek s vyhlazením zhorší jen mírně.
10. Zápis výsledku: _set_cell_slowness
Rychlosti \(1/x_j\) neznámých buněk se zapíší přes _update_cell_velocity, které použije
masku obvodu (buňky mimo kmen zůstanou prázdné) a smaže hodnoty ze dříve spočítané metody.
Rychlost buňky se navíc zapíše do všech segmentů paprsků, které v ní leží, takže na výsledek
SIRT lze navázat nástroji pracujícími se segmenty. Matice \(A\) a vektor \(b\) se ukládají do
t._matrices.
11. Korekce anizotropie
Dřevo vede zvuk rychleji radiálně (od dřeně ke kůře) než tangenciálně. Při
fix_velocity_EBSI_function (v GUI přepínač anizotropie) se rychlosti paprsků před rekonstrukcí
upraví stejnou funkcí jako v metodě EBSI (fix_velocity_EBSI, viz
methods.md). Samotný SIRT je izotropní: buňka má jednu
rychlost pro všechny směry.
Část III – použití a nastavení
12. V aplikaci
Menu Tomograph → SIRT method. Parametry jsou v panelu „SIRT method parameters“ (pod
tomogramem je i report). Změna parametru tomogram nepřepočítá hned: nad zašedlým předchozím
tomogramem se vypíše seznam změn a použijí se tlačítkem „Recompute tomogram“ (nebo ihned
s přepínačem automatického přepočtu). Nastavení lze uložit tlačítkem „💾 Save to file“ do
config.yaml datové sady.
widget ( |
výchozí |
parametr |
|---|---|---|
|
10 |
|
|
12 (% průměru), 0 = tenké |
|
|
2000 |
|
|
1,5 (0,1–1,9) |
|
|
0 = automaticky |
|
|
0 = automaticky |
|
|
0 |
|
Panel „Reproduce in Jupyter“ ukáže kód, který dá stejný tomogram jako stránka.
13. V Jupyteru
Stejný výpočet jako stránka:
from tomotree import analysis, dataset

config, data = dataset.load_dataset("streamlit_data/Jičín_05")
t = analysis.reconstruct(data, method="SIRT", nx=41, ny=41,
                         sirt_smoothing=10, sirt_ray_width=0.12,
                         sirt_iterations=2000, sirt_relaxation=1.5)
print(t.sirt_report)
Přímé volání metody objektu Tomo (pozor: ray_width je zde šířka v jednotkách souřadnic
nebo 'auto', poměr k průměru je ray_width_ratio):
import tomotree as tomo

t = tomo.Tomo(nodes, times=times, nx=41, ny=41, symmetric=True, boundary='polygon')
print(t.do_SIRT_method(smoothing=10, ray_width='auto', ray_width_ratio=0.12,
                       iterations=2000, relaxation=1.5))
t.grid.velocity      # rychlosti buněk (m/s), NaN mimo kmen
Ukázky dalších variant jsou v demo/demo_SIRT.py, testy v tests/test_sirt.py.
14. Vliv parametrů na syntetickém stromu
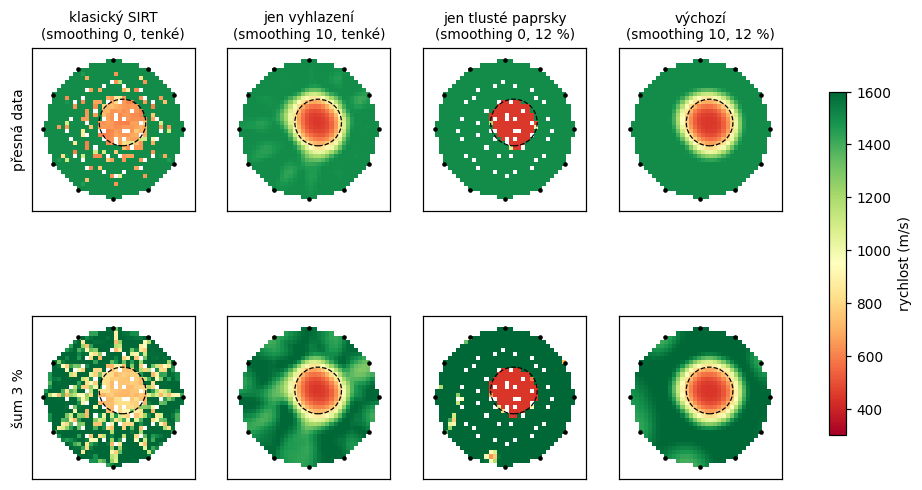
Co přidá vyhlazení a co tlusté paprsky, na přesných datech a s 3 % šumem (2000 iterací, \(\omega = 1{,}5\)).
varianta |
data |
reziduum |
RMSE (m/s) |
prázdné buňky |
|---|---|---|---|---|
klasický SIRT (smoothing 0, tenké) |
přesná |
0,0004 |
269 |
5 % |
klasický SIRT (smoothing 0, tenké) |
šum 3 % |
0,0000 |
310 |
5 % |
jen vyhlazení (smoothing 10, tenké) |
přesná |
0,041 |
156 |
0 % |
jen vyhlazení (smoothing 10, tenké) |
šum 3 % |
0,037 |
171 |
0 % |
jen tlusté paprsky (smoothing 0, 12 %) |
přesná |
0,084 |
121 |
5 % |
jen tlusté paprsky (smoothing 0, 12 %) |
šum 3 % |
0,075 |
169 |
5 % |
výchozí (smoothing 10, 12 %) |
přesná |
0,096 |
164 |
0 % |
výchozí (smoothing 10, 12 %) |
šum 3 % |
0,088 |
190 |
0 % |
Klasický SIRT má nejmenší reziduum a největší chybu: přizpůsobuje se šumu.
Tlusté paprsky bez vyhlazení dají ostrý obraz dutiny s nejmenší RMSE, ale nechají díry mezi paprsky a se šumem vytvoří artefakty u okraje.
Vyhlazení vyplní všechny buňky; hvězdice tenkých paprsků zmizí až s tlustými paprsky.
Výchozí kombinace je nejhladší a nejodolnější, za cenu rozmazaného okraje dutiny (RMSE měří hlavně tento okraj).
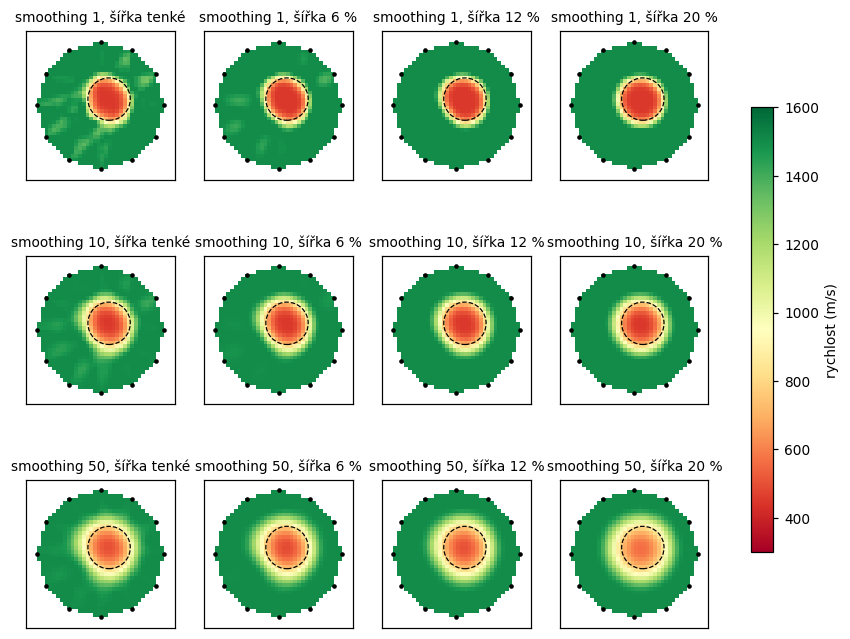
Vyhlazení (řádky 1, 10, 50) × šířka paprsku (tenké, 6, 12, 20 % průměru).
smoothing |
tenké |
6 % |
12 % |
20 % |
|---|---|---|---|---|
1 |
127 |
123 |
127 |
136 |
10 |
156 |
159 |
164 |
171 |
50 |
191 |
196 |
204 |
216 |
RMSE (m/s), 2000 iterací, \(\omega = 1{,}5\), přesná data.
Na přesných datech vychází nejlépe slabé vyhlazení (1). To ale neplatí obecně: syntetická data jsou bez šumu a přesně odpovídají modelu přímých paprsků. Reálná měření mají šum, ohyb paprsků i chyby v poloze senzorů, a tam slabé vyhlazení vrací hvězdice a ostrůvky. Silné vyhlazení (50) defekt výrazně zeslabí.
varianta |
reziduum |
RMSE (m/s) |
odhad \(t_0\) |
|---|---|---|---|
bez zpoždění |
0,096 |
164 |
– |
zpoždění 40 µs, bez odhadu |
0,092 |
243 |
– |
zpoždění 40 µs, |
0,096 |
166 |
40,8 µs |
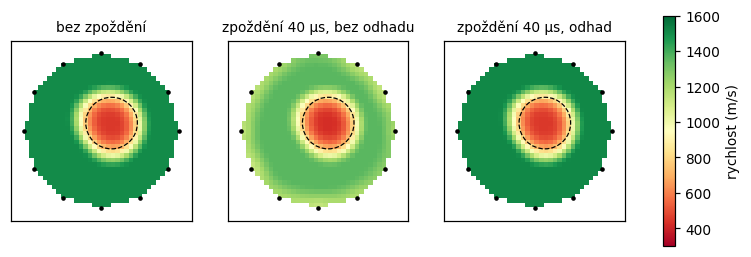
Zpoždění 40 µs (asi 10 % doby průletu) zpomalí celý tomogram. Po odečtení reakčního času (oddíl 8) vyjde tomogram prakticky stejný jako bez zpoždění.
15. Jak nastavit parametry
situace |
doporučení |
|---|---|
běžné měření, 8–16 senzorů |
výchozí hodnoty |
obraz „skvrnitý“, ostrůvky, hvězdice |
zvýšit |
defekt rozmazaný, hodně senzorů a kvalitní data |
snížit |
výsledek se mění s počtem iterací |
zvýšit |
mnoho buněk na dolní mezi (report) |
zkontrolovat data (vadné paprsky), případně ručně |
podezření na zpoždění přístroje |
zadat reakční čas přístroje; odhad z dat ( |
Čtení reportu: relativní reziduum kolem 0,05–0,15 je s výchozím vyhlazením normální; mnohem menší znamená, že metoda sleduje šum, mnohem větší, že vyhlazení je příliš silné nebo data nejsou konzistentní. Mnoho buněk na horní mezi u kůry je obvyklé (zdravé dřevo dosáhne rychlosti nejrychlejšího paprsku).
16. Srovnání s ostatními metodami a omezení
FBP řeší stejnou soustavu se stejnými tlustými paprsky, regularizuje ale odchylkou od homogenního modelu a jedním výpočtem bez iterací; obrazy bývají podobné (backprojection.md §8).
EBSI/ERSM nejsou inverze soustavy \(Ax = b\), ale interpolace rychlostí paprsků; časy obecně nesplňují.
Přímé paprsky. Vlna ve skutečnosti obchází dutinu dřevem (nejrychlejší cesta), takže pomalé oblasti se jeví menší a mírně rychlejší, než jsou. Ohyb paprsků není implementován.
Zdravý prstenec u kůry je spíš horní odhad: buňky tam často dosáhnou horní meze.
Konvergence s vyhlazením je pomalá; při velmi silném vyhlazení nebo jemné mřížce zkontrolovat, že se výsledek s dalšími iteracemi nemění (oddíl 9).
Reakční čas je společné nastavení všech metod; odhad z nejrychlejších paprsků je jen nápověda a při hnilobě uprostřed nejde určit.
Literatura
A. van der Sluis, H. A. van der Vorst (1990): SIRT- and CG-type methods for the iterative solution of sparse linear least-squares problems. Linear Algebra and its Applications 130, 257–302.
P. Gilbert (1972): Iterative methods for the three-dimensional reconstruction of an object from projections. Journal of Theoretical Biology 36, 105–117.
A. C. Kak, M. Slaney (1988): Principles of Computerized Tomographic Imaging, kap. 7 (algebraické rekonstrukce). IEEE Press.
H. Maurer, S. I. Schubert, F. Bächle, S. Clauss, D. Gsell, J. Dual, P. Niemz (2006): A simple anisotropy correction procedure for acoustic wood tomography. Holzforschung 60(5), 567–573 (reakční čas jako další neznámá soustavy, viz methods.md).